Schreiben und Redigieren
Überarbeitet, was da ist, statt es in die eigene Stimme umzuschreiben.
Eine Tabelle, zwei Exporte, ein Monat Nutzungsdaten. Der Unterschied dazu, ein Modell einfach auf deine Daten schauen zu lassen: Hier wird gezählt, und was gezählt wurde, wird gezeigt, damit du es prüfen kannst.
xlsx, csv oder tsv. Formeln kommen mit; es liest, was sie berechnen.
Eine Anzahl, ein Median, eine Differenz, nicht «was hältst du davon».
Das Werkzeugergebnis steht in der Antwort, so lässt sich die Zahl bis zu den Zeilen zurückverfolgen.
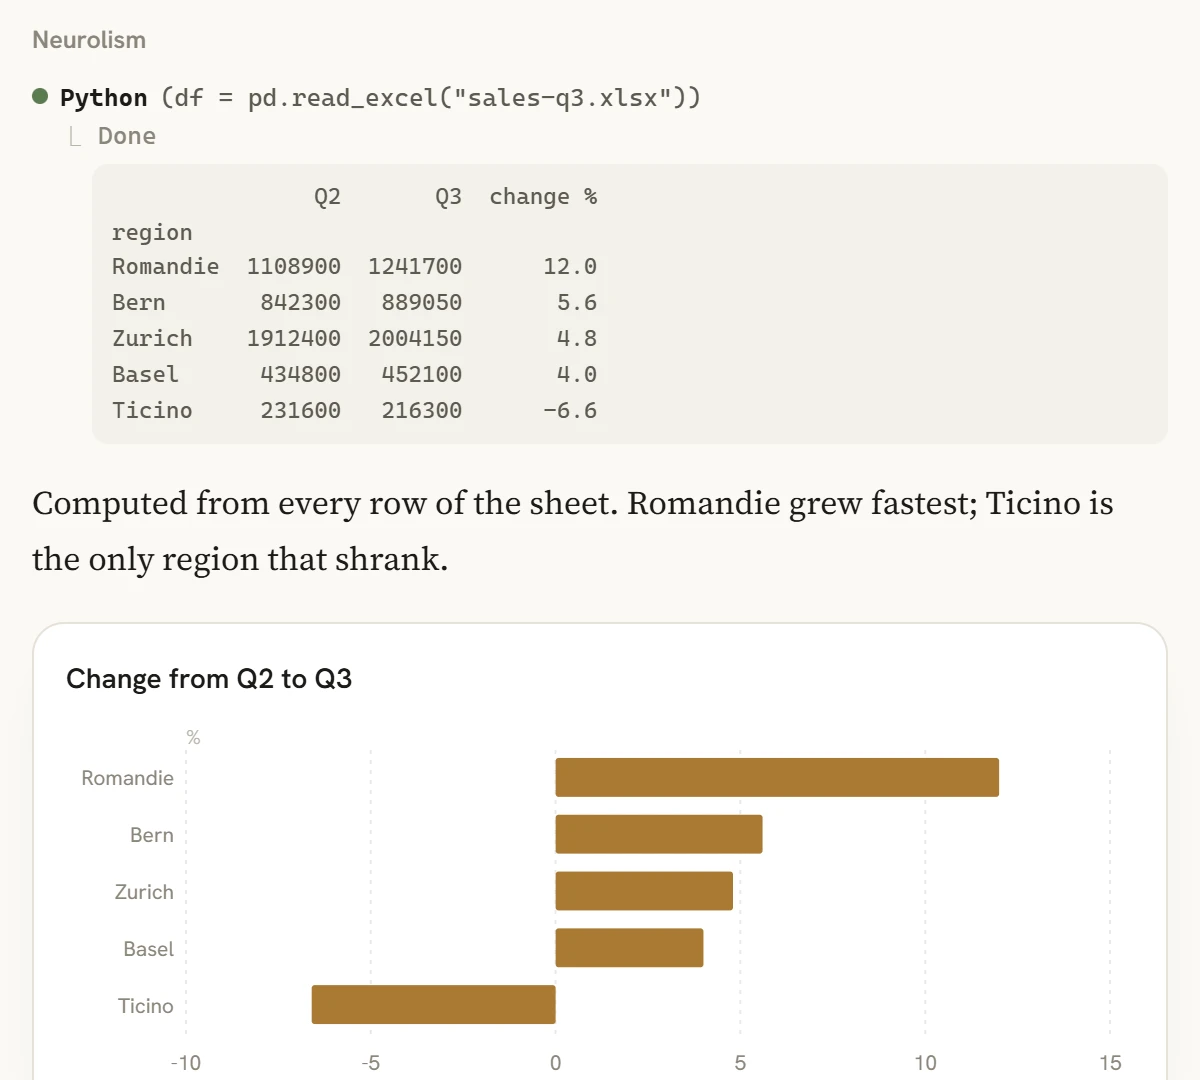
Häng eine Tabelle an, und es führt in deinem Browser Python darauf aus: Pivots, Statistik, Regressionen. Die Analyse läuft auf deinem Computer, und das Ergebnis fliesst in die Antwort.
Es entscheidet nicht, was die Zahlen bedeuten. Eine Korrelation ist eine Zahl; ob dahinter eine Ursache steckt, ist eine Frage über die Welt, und keine Tabelle beantwortet sie. Wo das Modell deuten statt zählen muss, sagt es, welcher Teil was war.
Hier ist der Export des letzten Quartals. Welche Kostenstellen liegen mehr als zwei Standardabweichungen von ihrem eigenen Zwölfmonatsschnitt entfernt, und um wie viel?
Medium reicht zum Lesen und Zählen. Large lohnt sich, wenn die Frage viele Blätter auf einmal umfasst.
Grössen vergleichenFür alles Statistische ruft es ein Werkzeug auf oder führt Python in deinem Browser aus, und das rechnet. Fragt man in Prosa nach einem Median, sortiert ein Modell im Kopf und landet in der Nähe, und in der Nähe des Medians ist eine andere Zahl.
Das hängt vom Abo ab; die Grenze steht vor dem Hochladen da. Sehr grosse Tabellen fragt man besser ab, statt sie anzuhängen.
Kein Training, keine Auswertung, kein Profiling. Sie werden verarbeitet, um deine Frage zu beantworten, und für nichts anderes.
Überarbeitet, was da ist, statt es in die eigene Stimme umzuschreiben.
Findet die Stellen. Sagt dir nicht, dass sie in Ordnung sind.
Die kleinen, exakten Dinge, exakt erledigt.